 閱讀時間約 3 分鐘
一分鐘摘要
- 6.9% 購買意圖與 12.1% 品牌提及不可混用
- 研究剔除重度用戶並作人口加權
- 樣本比例不能代表整體 ChatGPT 廣告成效
研究中的 6.9% 與 12.1% 量度不同事情
品牌在評估 ChatGPT 曝光價值時,消費者有沒有打算購買,以及回答有沒有提及品牌,是兩個不同問題。SparkToro 使用 Verso 的美國自願參與樣本研究 ChatGPT 對話,兩項結果分別為約 6.9% 及 12.1%,不能合併理解為購買比例。
據 Search Engine Journal 整理,研究的加權組別中,約 6.9% 對話被歸類為有購買意圖,包括研究購買選項,以及針對特定品牌、產品或服務提出購買相關問題。研究正文以 prompts 描述6.9%,圖表標題則以 conversations 表述。
12.1% 則是回答提及至少一個品牌、產品或公司的比例。當中 7.0% 提及多個,5.1% 提及一個;其餘 87.9% 沒有提及任何品牌、產品或商戶。回答出現品牌名稱,本身不足以證明用戶準備購買,更不能當作成交或廣告成效。
SparkToro 作者在結論中亦以約 12% 描述購買旅程相關使用,但這與購買意圖圖表的 6.9% 並不相同。品牌引用研究時,應直接標明所量度的是購買意圖,還是回答中的品牌提及。
資料來自自願分享對話的美國用戶
研究原始資料涵蓋 2026 年 1 月 1 日至 10 月 29 日,來自 12321 人的 41961 段完整對話,共 118163 則 prompts。參與者自願向 Verso 分享 ChatGPT 歷史紀錄。
分析前,研究剔除了 131 名重度用戶,門檻為每個活躍月份平均超過 33 則 prompts。這批人約佔樣本人數 1%,卻產生了 21% 的 prompts。剔除他們有助減少少數高用量用戶主導結果,但亦意味研究不能完整描述這批用戶的行為。
樣本較偏向年輕、女性及較低收入人士。研究以具人口資料的 9675 名參與者,按 2024 年美國人口普查的年齡、性別、地區、教育及家庭收入目標加權;加權後,各使用類別的比例變動均不超過 1.4 個百分點。
研究亦同時檢視每段對話的比例,以及先計算每名用戶的使用組合、再取平均的結果。引用個別圖表時,仍須交代其計算方式,不能將所有百分比視為同一分母。
AI 編碼如何分類,驗證又涵蓋甚麼?
研究先制定包含 34 種細分意圖、歸入 12 個大類的編碼規則,再由 Anthropic 的 Claude 分類。每段對話只獲分配一個主要用途標籤。
分類模型看到的內容包括自動產生的標題、最多六則用戶 prompts、ChatGPT 首幾次回答的開頭,以及產品或地點卡片與粗體名稱。若要求產生內容,分類會優先按輸出類型處理。例如要求撰寫退款電郵,會計入寫作,而非購物。
第二名獨立編碼者重新分類隨機樣本,用途分類的一致率為 90%,品牌標籤則為 97% 至 99%。不過,報導指出,研究沒有另外公布購買意圖辨識的一致率,因此不能直接將品牌標籤的驗證數字套用到 6.9% 的結果。
對品牌曝光與廣告市場的意義
研究作者 Rand Fishkin 是 SparkToro 聯合創辦人而且行政總裁,SparkToro 銷售受眾研究軟件。他據此質疑 ChatGPT 的廣告機會,並認為 Google AI Overviews 及 AI Mode 才是 AI 曝光的重要推動因素。這些屬於作者對結果的商業判斷,應與樣本觀察分開閱讀。
研究主要記錄手機使用,桌面及工作帳戶使用可能不足,亦不包含 API 請求。作者明言,這批資料較適合說明人們向 ChatGPT 問甚麼,而非量度他們使用多少。美國自願參與樣本亦不能直接代表香港用戶。
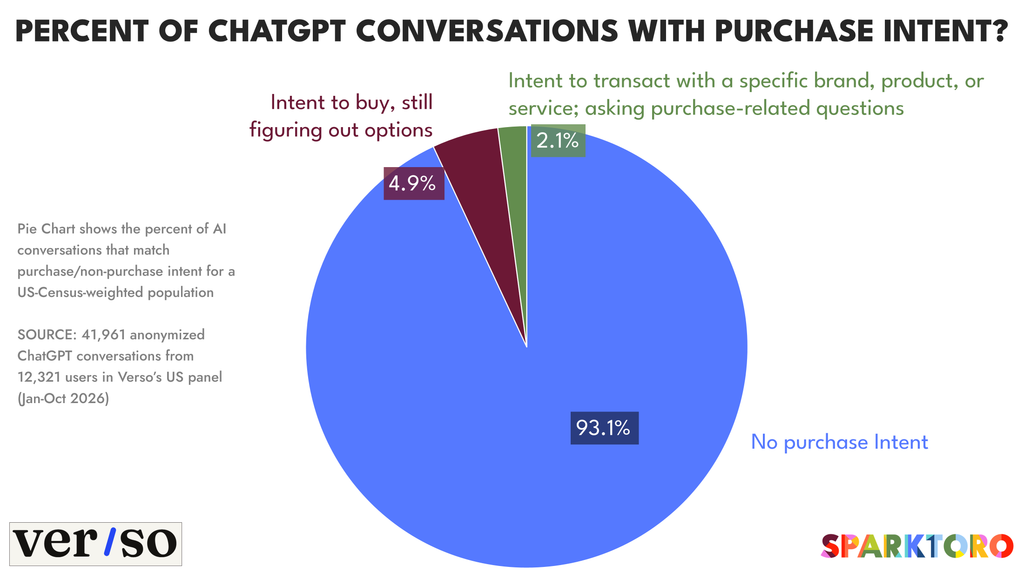
圖片來源:SparkToro/Verso,美國樣本研究。圖表兩個購買類別分別列為4.9%及2.1%,合計7.0%,與作者正文6.9%略有差異。