 閱讀時間約 3 分鐘
一分鐘摘要
- Meta 將特徵部署與共用運算分開
- 可比較的特徵提取項目上線速度約為舊框架的 3.6 倍
- 數字不代表廣告成效或廣告成本改善
Meta 更新的是廣告模型背後的基建
Meta 公開了廣告機器學習基建 F3 Lightning,處理廣告排名模型背後一個問題:工程團隊如何更快將模型需要的特徵投入正式運作,同時維持原有運算效率。
對廣告主及 agency 而言,這則消息值得留意的地方,是 Meta 如何縮短模型迭代所需的時間。Meta 表示,可比較的特徵提取項目,上線速度約為舊版 F3 的 3.6 倍,基建運算成本沒有增加。
這個數字衡量內部特徵的上線速度,不能用來推算廣告成效會提高多少,或廣告費會降低多少。
為何一個特徵出錯,會拖慢其他更新?
F3 是 Meta 用來編寫、編譯及提供廣告排名模型特徵的框架。這裏的「特徵」,是模型作預測時使用的資料值,例如一段時間內的 click次數、曝光次數,以及由兩者計算的 click率。單次請求可能需要超過 20000 個特徵。
準備這些資料值,往往涉及重複工序。例如計算七日 click次數及七日曝光次數,可能都要讀取同一批事件,再篩選同一個時間範圍。舊版 F3 會將各個特徵的運算合併成一張圖,讓共用步驟只執行一次,減少重複運算。
問題在於,這張合併圖同時也是整批更新的發布單位。一個特徵定義有錯,便可能令其他已經準備好的特徵一同等待。修改現有模型正在使用的特徵,還需要額外模型測試;由於整批一起發布,其他特徵也要等測試完成。
F3 Lightning 讓特徵分開發布,運算仍然共用
F3 Lightning 建立在 F3 之上,將發布邊界與執行邊界分開。每個特徵可以獨立編譯、驗證、部署及回復至先前版本,一個特徵出問題,不再必然阻止其他特徵發布。
發布流程亦會按影響及風險安排次序。尚未被模型使用的新特徵,可以經標準驗證後較快發布;已被運作中的模型使用的特徵,修改前則需要額外測試。
不過,獨立發布本身並不能保證效率。Meta 表示,早期原型讓每個特徵各自執行,結果重複讀取、篩選及彙總資料,CPU 用量高於舊版 F3。
團隊因此重新加入共用執行機制,但保留獨立發布的安排。服務啟動時,系統會識別相同運算,整理成一份共用執行次序,讓多個特徵需要的同一步驟只執行一次。
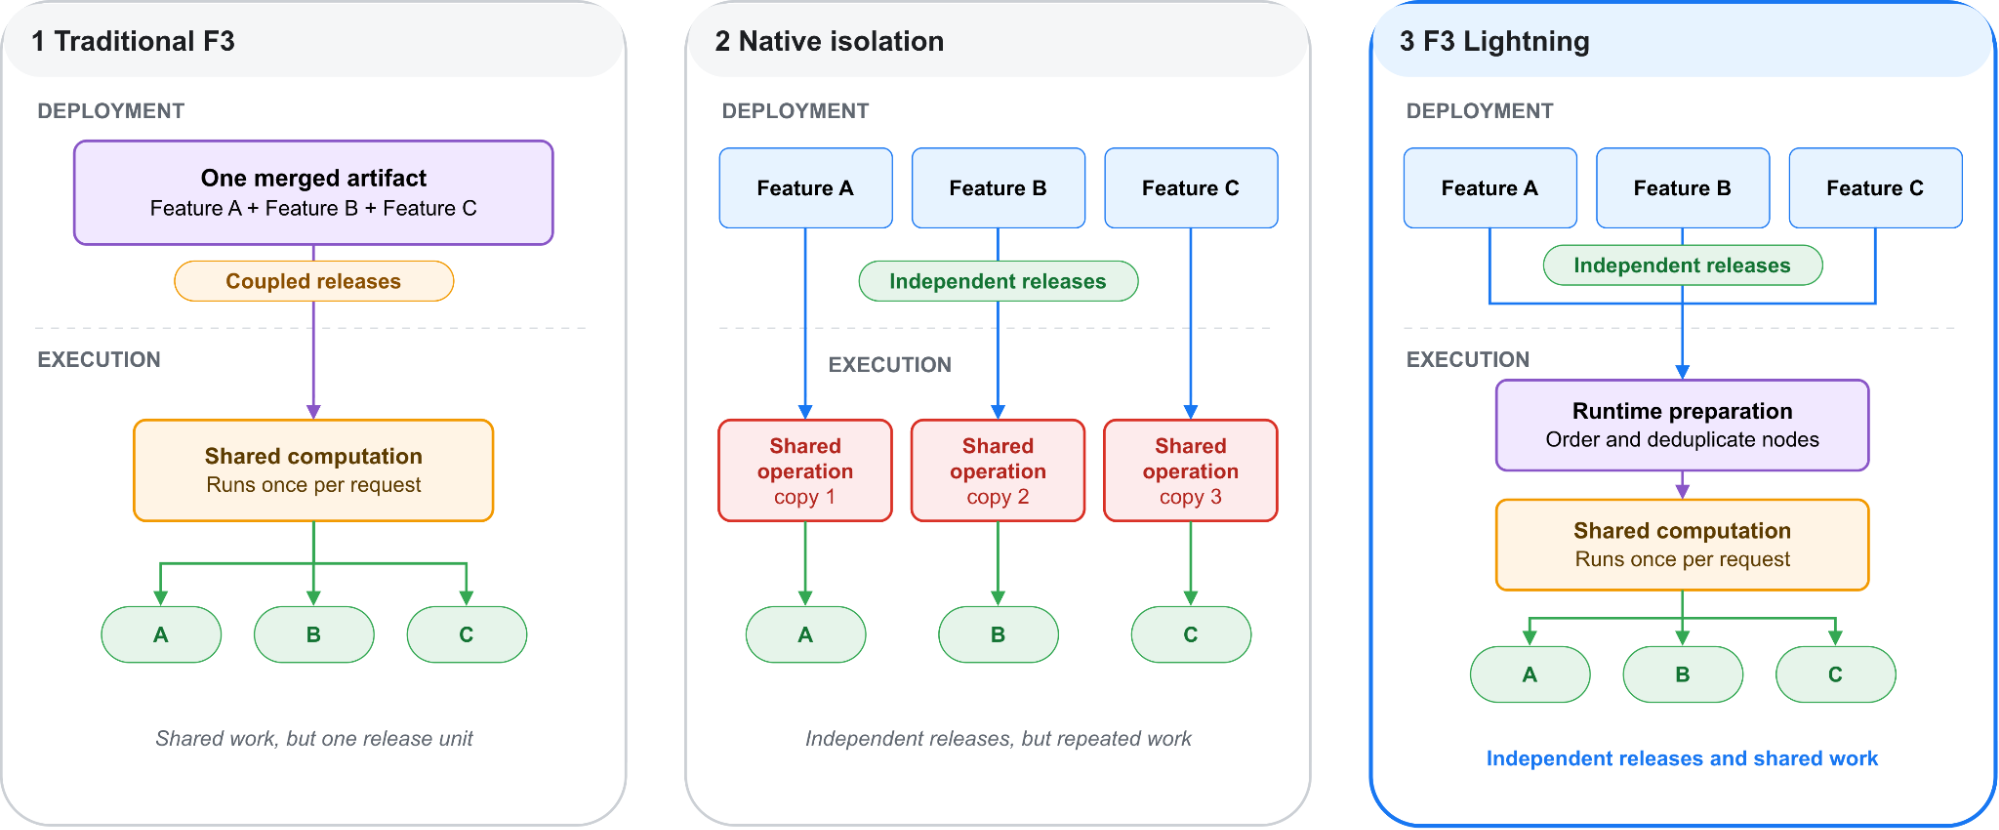
圖片來源:Engineering at Meta,2026 年 11 月 3 日。左圖為舊版,中圖為早期獨立發布方式,右圖為 F3 Lightning。
減少重複運算後,還要處理記憶體成本
Meta 發現,即使已經消除重複運算,CPU 用量仍未回到舊版水平。原因是中間結果分散在不同記憶體位置,執行時需要來回存取。
F3 Lightning 改為讓每次請求使用一個共用記憶體緩衝區,減少分散存放及重複複製結果。系統也會在啟動時,將運算識別碼轉成連續整數位置,之後可以直接讀取陣列中的結果,省去每次存取時查找識別碼的工序。
Meta 表示,這些調整共同維持了原有運算效率。獨立發布帶來的便利,才沒有變成每次廣告排名請求都要承擔的額外運算成本。
廣告主應如何理解這次更新?
Meta 將這次成果連結到模型迭代:特徵發布週期縮短,代表同一段時間內,可以進行更多模型改進及重新訓練。
對負責落廣告及向客戶交代成效的團隊,這次披露有助分清平台更新的種類。模型能否更快改進,除了取決於模型本身,也取決於所需資料特徵能否通過驗證、順利發布,以及在正式運作時保持效率。
但這篇工程文章沒有提供廣告成效測試結果,也沒有交代香港廣告帳戶的個別影響。因此,約 3.6 倍應保留在「可比較特徵的上線速度」這個範圍內,不能直接延伸為你帳戶的 click率、轉換率或廣告回報改善。
現階段是否需要調整廣告?
這篇公告沒有提出廣告主需要更改設定,也沒有公布個別帳戶的推出時間表。單憑內部部署速度,尚不足以支持加預算或更換素材的決定。
例如,agency 向客戶解釋這次更新時,可以交代 Meta 正縮短模型特徵的發布週期;至於能否帶來更多查詢或訂單,仍要看帳戶本身的轉換及每次獲客成本。工程速度與業務結果分開評估,才能避免用平台公告代替成效證據。